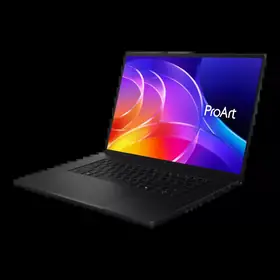
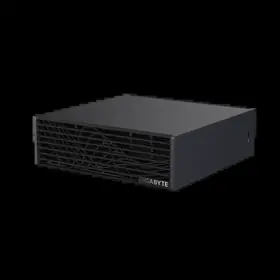
- RTX Spark, portable et bureau
- DGX Spark, 128 Go unifiés

Vous voyez le stock de Cybertek sur toutes les catégories
Imaginez un plan de travail : chaque outil d'IA y prend de la place. Quand il n'y en a plus, rien ne marche. Choisissez une machine, puis ajoutez des outils.
Défi : faites tenir l'assistant « Avancé ».
Survolez un outil pour savoir à quoi il sert.
Posez la même question à trois machines et comparez leurs réponses.
Simulation pédagogique : réponses et vitesses illustratives.
Une RTX 5090 atteint 1,8 To/s, un DGX Spark offre 273 Go/s : le PC RTX est plus rapide sur ce qui tient en VRAM, le Spark fait tourner des modèles bien plus gros.
Les modèles à experts n'activent qu'une partie de leurs paramètres par jeton : un 120 Md MoE peut répondre plus vite qu'un 70 Md dense.
MSI annonce environ 15 tokens/s sur un 120 Md avec son AI Edge (128 Go).
Aucune donnée transmise à un tiers : RGPD et secret professionnel plus simples à tenir.
Ollama et LM Studio exposent une API locale compatible OpenAI ; le cloud reste possible ponctuellement.
À retenirPlus la machine a de mémoire, plus l'IA qu'elle fait tourner est grande et précise.
Étape suivante : Ce que ça coûteRecherche sur le web, analyse experte, agents qui travaillent des heures.
Documents confidentiels, images en série, assistant sur vos propres fichiers.
Envoyées chez le fournisseur, parfois conservées plusieurs semaines.
Elles ne quittent pas votre bureau.
AvantageLes plus performants (97 % au SWE-bench pour Claude Opus 5), mis à jour en continu.
AvantageEnviron un an de retard : très bons pour écrire, résumer, coder ; plus faibles sur les agents longs.
De 8 à 103 € par mois, plus les jetons d'API : la facture suit l'usage.
Dès 3 700 € environ, puis l'électricité : le coût ne bouge plus avec l'usage.
Plafonds de messages, heures de pointe, connexion obligatoire.
Aucun quota, fonctionne hors connexion.
AvantageImmédiate, rien à gérer ; le fournisseur peut changer ses modèles et ses prix.
AvantageLivré prêt à l'emploi par Cybertek. Quelques mises à jour, et il accueille les nouveaux modèles ouverts.
Dans le cadre prévu par le fournisseur.
Vos modèles, vos agents, vos documents, réglés comme vous le voulez.
AvantageOpenAI, page « Your data » (échanges API conservés jusqu'à 30 jours pour contrôle des abus) ; écart de qualité : SWE-Bench Verified 86 % pour le meilleur modèle local contre 97 % pour Claude Opus 5 (vals.ai, 3 oct. 2026), agents 43 à 46 % contre 61 % (TerminalBench Hard, Artificial Analysis, août 2026) ; abonnements : ChatGPT Go 8 € à ChatGPT Pro dès 103 € (relevés oct. 2026) ; machines : portables RTX Spark de 3 699,90 € à 7 999,90 € (Grosbill, 24 oct. 2026), prix catalogue Cybertek à reprendre avant publication.
À retenirLa plupart des pros combinent les deux : le PC IA au quotidien pour le confidentiel et le répétitif, le cloud pour les tâches les plus pointues.
Étape suivante : Votre métier
Créez images et visuels à volonté, sans abonnement ni attente, et gardez les fichiers de vos clients chez vous.
Une machine milieu de gamme suffit pour démarrer.
Un PC IA monté dans notre atelier, ou un portable si vous bougez beaucoup.
Un assistant qui complète et relit votre code, et cherche dans votre documentation, sans que rien ne sorte de chez vous.
Dépôt, contexte et agents réclament de la mémoire : visez le haut de gamme.
Posez une question à vos devis, contrats et factures. Rédigez, résumez, traduisez, sans envoyer vos dossiers clients.
Une machine milieu de gamme, livrée prête à l'emploi.
Un assistant vocal et des sous-titres en direct, sur la carte graphique qui fait déjà tourner vos jeux.
Votre PC de jeu récent fait souvent déjà l'affaire.
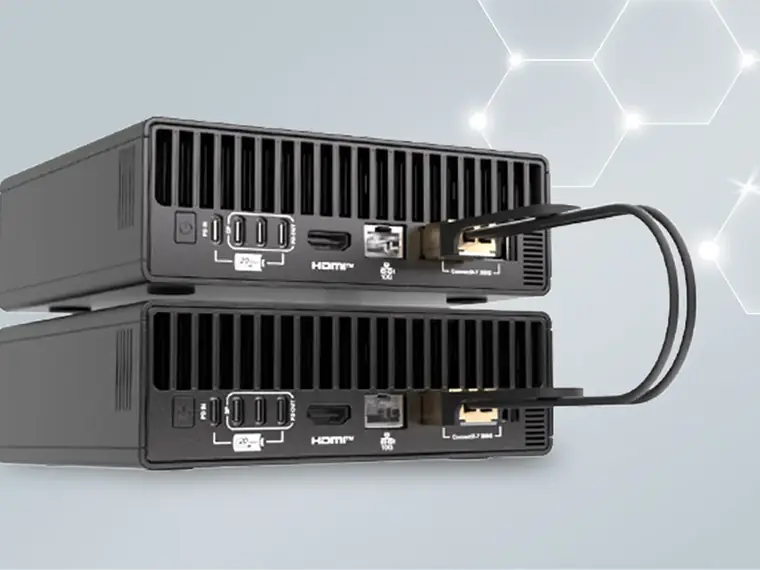
Plusieurs postes, serveur d'inférence partagé, cartes RTX PRO, grappes de DGX Spark.
À retenirVotre métier fixe le niveau de machine.
Étape suivante : Votre machine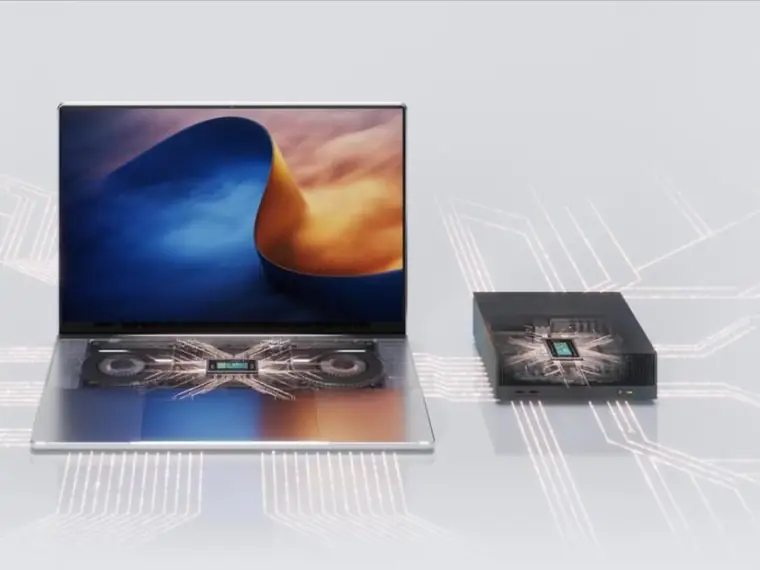
À retenirLe quiz vous donne la machine conseillée, et une option moins chère.
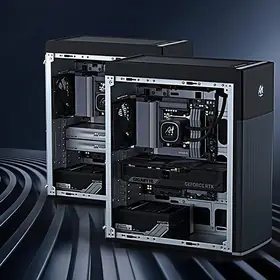
Étape suivante : Passer à l’actionFamille NVIDIA Spark · RTX Spark portable, RTX Spark bureau, DGX Spark : même architecture Blackwell, trois façons de travaillerComparer les trois Spark Une tour montée dans notre atelier, évolutive, qui fait aussi tourner vos jeux et vos logiciels habituels.
Vous voulez démarrer avec l'IA sans changer vos habitudes : vos jeux et logiciels fonctionnent comme avant.
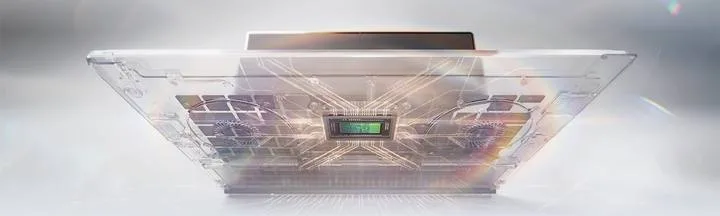
Portables et PC de bureau compacts à mémoire unifiée : de très gros modèles sous Windows 11.
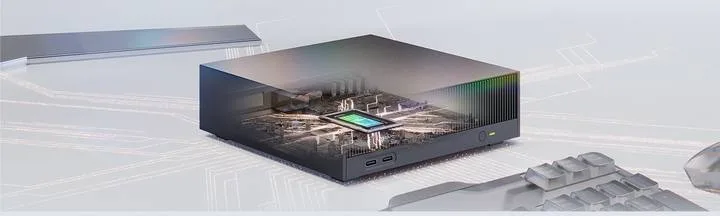
Vous voulez de très gros assistants sous Windows, au bureau ou en déplacement.
Certains logiciels anciens et quelques jeux ne fonctionnent pas encore. Un conseiller vérifie votre liste.
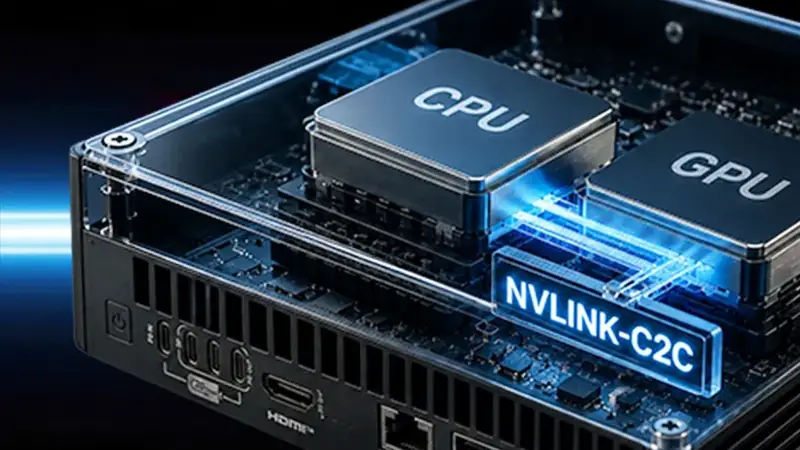
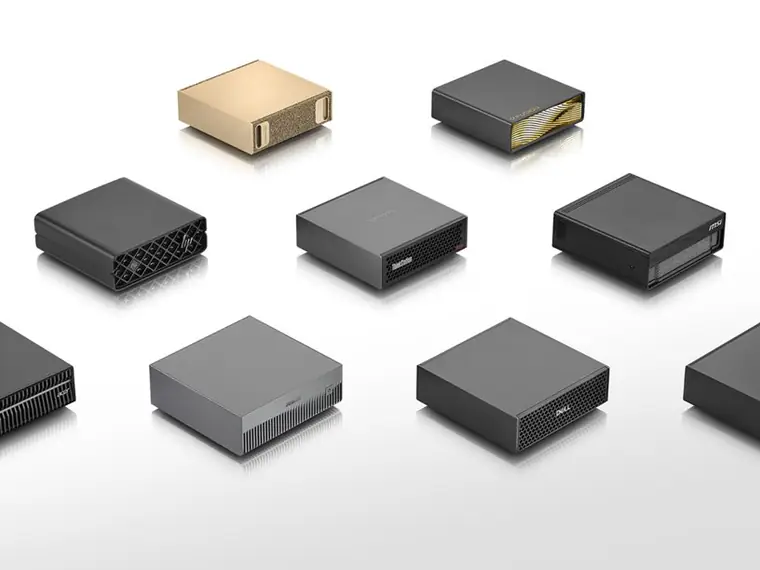
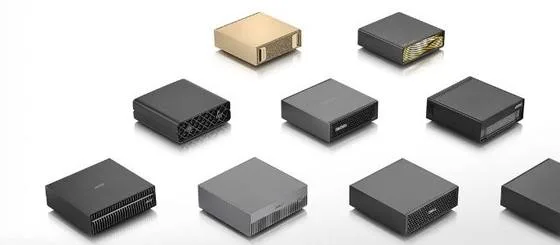
Un boîtier de 150 mm de côté et 128 Go, pour créer et entraîner vos propres outils d'IA.
Vous développez vos propres outils d'IA et travaillez sous Linux.
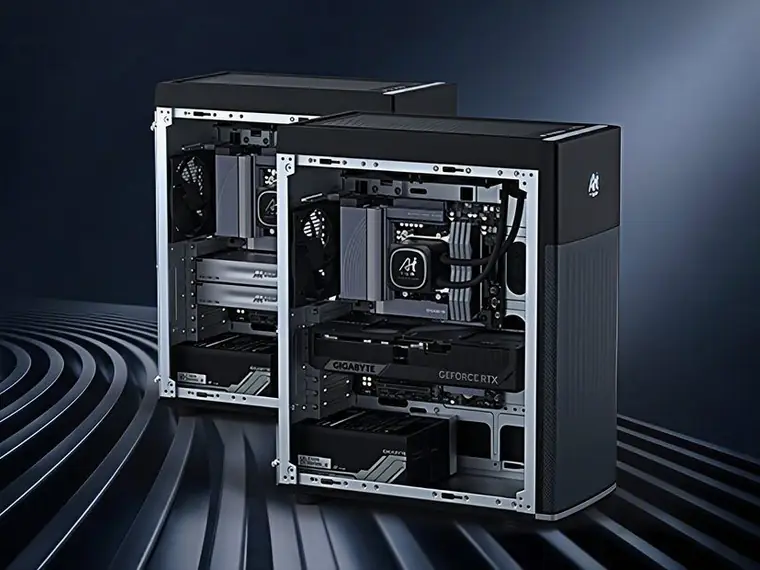
La machine la plus puissante, montée et testée dans notre atelier.
Vous entraînez vos propres modèles ou servez plusieurs personnes à la fois.
Dernière étapeConfigurez votre machine, ou venez la découvrir en magasin.
Configurer ma machine
Interrogez un dossier entier, des milliers de documents d'un coup.
Apprenez-lui votre style à partir de vos propres visuels.
Agents qui lancent tests et recherches, à partir de 48 Go unifiés (repère NVIDIA).
| PC IA RTX 32 Go | RTX Spark | DGX Spark | Workstation IA | |
|---|---|---|---|---|
| Puce | GPU RTX x86 | N1X (Grace Arm + Blackwell) | GB10 | RTX PRO ou 2 GPU |
| Mémoire IA | 32 Go VRAM | 24 à 128 Go unifiés | 128 Go unifiés (64 Go chez certains constructeurs) | jusqu'à 96 Go par carte |
| Bande passante | jusqu'à 1,8 To/s | non publiée par NVIDIA | 273 Go/s | jusqu'à 1,8 To/s par carte |
| Système | Windows x86 | Windows 11 (Arm) | DGX OS (Linux) | Windows ou Linux x86 |
| Modèle max | 33 Md (32 Go de VRAM) | 12 à 200 Md selon la mémoire | 200 Md (100 Md en 64 Go) | selon configuration |
| Fine-tuning | petits modèles (LoRA) | limité | jusqu'à 70 Md | oui, multi-GPU |
| Test | PC IA RTX 32 Go | RTX Spark 64 Go | DGX Spark | Workstation IA |
|---|---|---|---|---|
| Llama 3 8B, tokens/s | mesure à venir | mesure à venir | mesure à venir | mesure à venir |
| Llama 3 70B, tokens/s | ne tient pas | mesure à venir | mesure à venir | mesure à venir |
| FLUX.1 dev, images/min | mesure à venir | mesure à venir | mesure à venir | mesure à venir |
Protocole : même modèle, quantification 4 bits, prompt de 1 000 jetons, moyenne de 5 passages.
Mémoire ≈ paramètres × (bits ÷ 8) + cache de contexte (2 à 8 Go)
| Modèle | FP16 | 8 bits | 4 bits | Palier |
|---|---|---|---|---|
| Llama 3 8B | 16 Go | 8 Go | 4,7 Go | IA 16 |
| 14 Md | 28 Go | 14 Go | ≈ 9 Go | IA 16 |
| 32 Md | 64 Go | 32 Go | ≈ 20 Go | IA 32 |
| Llama 3 70B | 140 Go | 70 Go | 39 Go | IA 64 |
| 120 Md | 240 Go | 120 Go | ≈ 65 Go | IA 128 |
Plusieurs postes, RTX PRO, grappes DGX Spark : devis sous 24 h avec Cybertek Pro.